



Je wilt een taalmodel (een programma dat tekst leest en schrijft, zoals ChatGPT of Claude) een dossier van driehonderd pagina's laten samenvatten, maar je cliënt rekent op je beroepsgeheim. Het korte antwoord: namen zwart maken is niet genoeg, en echt anonimiseren lukt bij een dossier zelden volledig. In de praktijk pseudonimiseer je: je vervangt namen door codes en bewaart de sleutel zelf. Dit artikel laat zien wat het verschil is, wat de AVG vraagt en welke stappen je kantoor kunt zetten voordat een taalmodel een dossier ziet.
Pseudonimiseren vs anonimiseren: het verschil in gewone taal
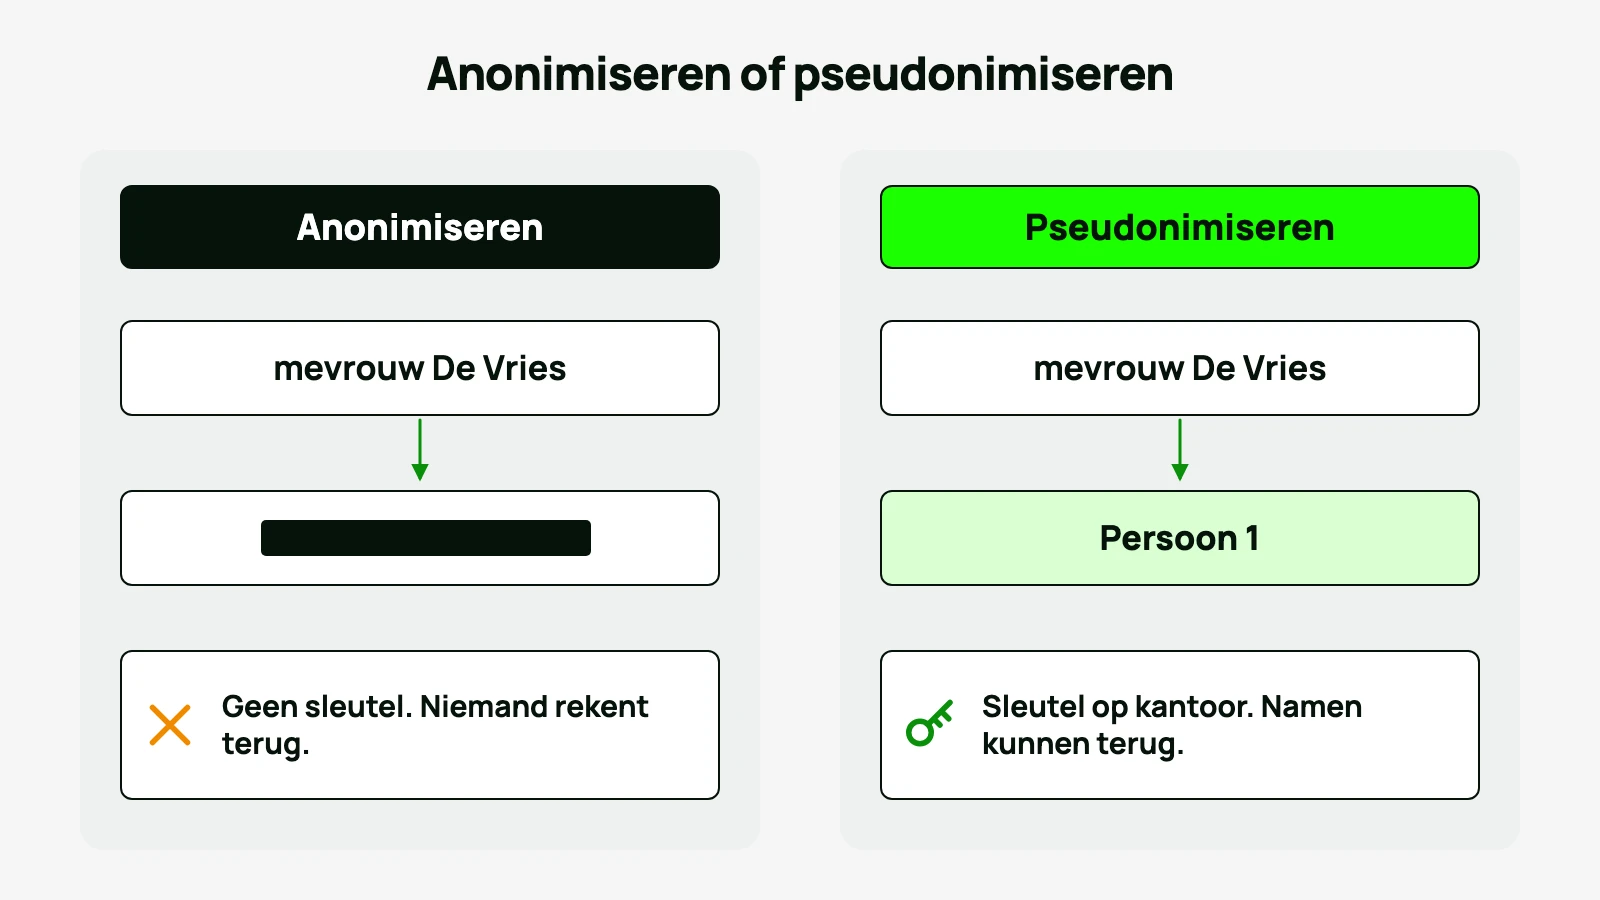
Anonimiseren betekent dat je gegevens zo bewerkt dat niemand nog kan achterhalen om wie het gaat. Niet jij, niet je collega, niet het taalmodel. Er bestaat geen sleutel meer om terug te rekenen.
Pseudonimiseren gaat minder ver. Je vervangt “Jansen Installatie B.V.” door “Partij A” en “mevrouw De Vries” door “Persoon 1”. Ergens bewaar je een lijst die zegt wie welke code is. Met die lijst zet je de namen later terug. Daarom is het zo bruikbaar: je wilt na afloop een concept met de echte namen erin.
Het verschil tussen anonimiseren en pseudonimiseren komt dus neer op één vraag: kan iemand, met welke hulp dan ook, terugrekenen naar de persoon? Bij anonimiseren is het antwoord nee. Bij pseudonimiseren is het antwoord ja, voor wie de sleutel heeft.
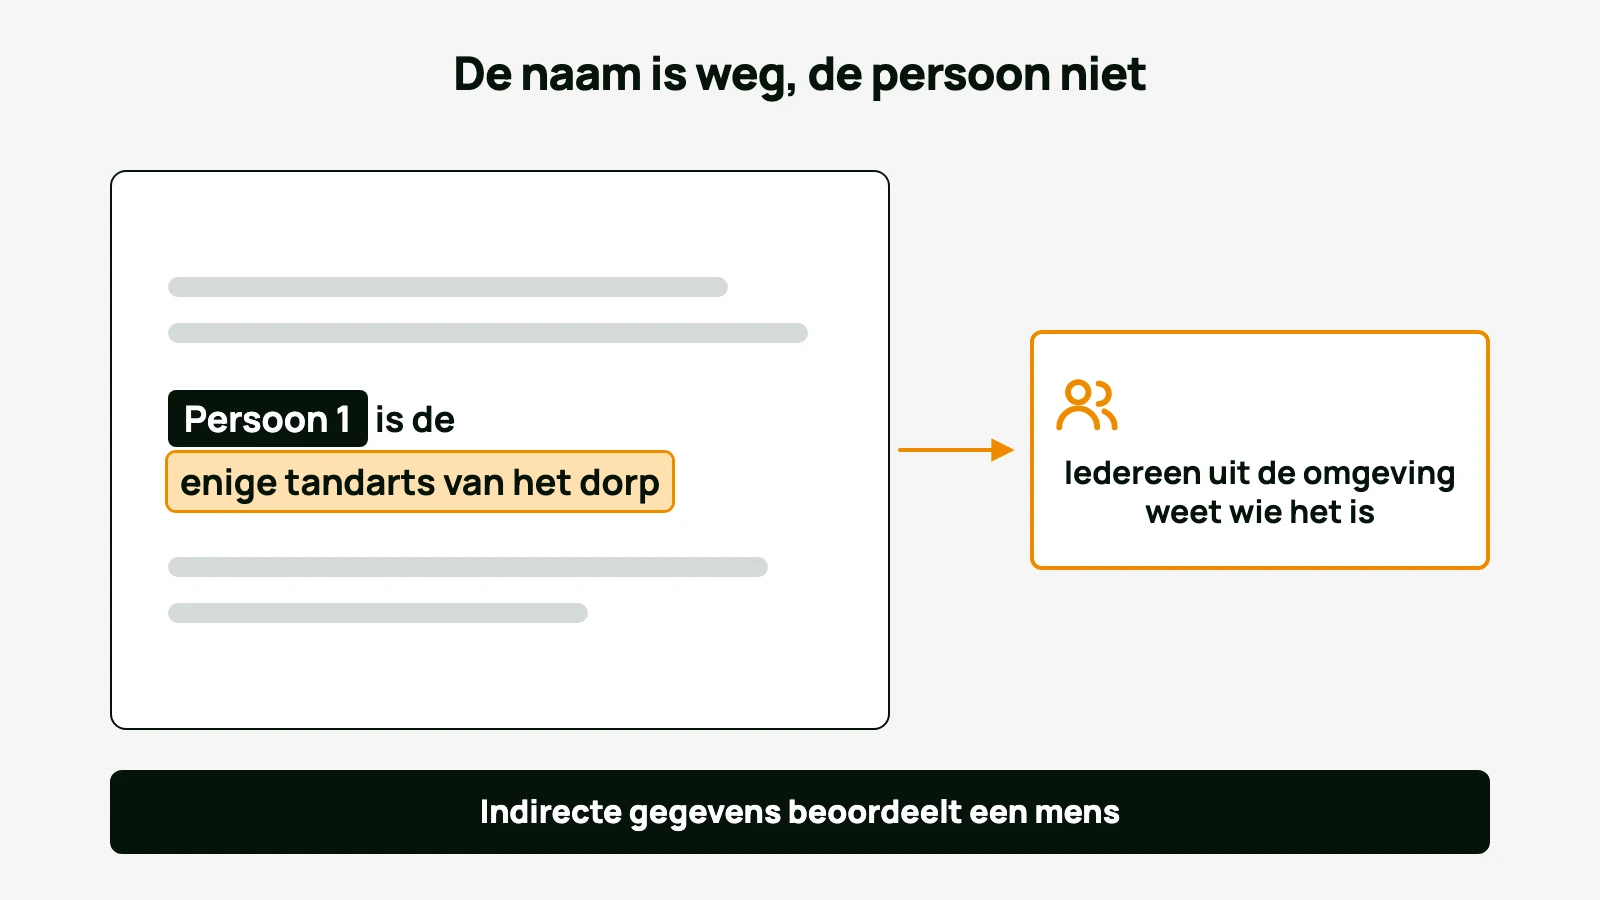
Een scenario als voorbeeld. Een kantoor verdedigt een tandarts die als enige in een dorp praktijk houdt. Je vervangt de naam door “Persoon 1”, maar laat “de enige tandarts van het dorp” staan. Elke lezer uit de omgeving weet dan wie het is. De naam is weg, de persoon niet. Daarom is namen zwart maken zelden genoeg.
Hoe je dit voor een advocatenkantoor praktisch inricht, lees je bij dossiers anonimiseren met AI.
Wat je kunt vragen: aan elke leverancier en medewerker: “Kan iemand, ook jullie, uit het resultaat afleiden om wie het gaat, en waar staat de sleutel?”
Anonimiseren volgens de AVG: wanneer valt een dossier buiten de wet?
AVG staat voor Algemene verordening gegevensbescherming, de Europese privacywet. De regel in gewone woorden: gegevens die echt anoniem zijn, vallen buiten de wet. Gepseudonimiseerde gegevens blijven persoonsgegevens, omdat de persoon met de sleutel te vinden is.
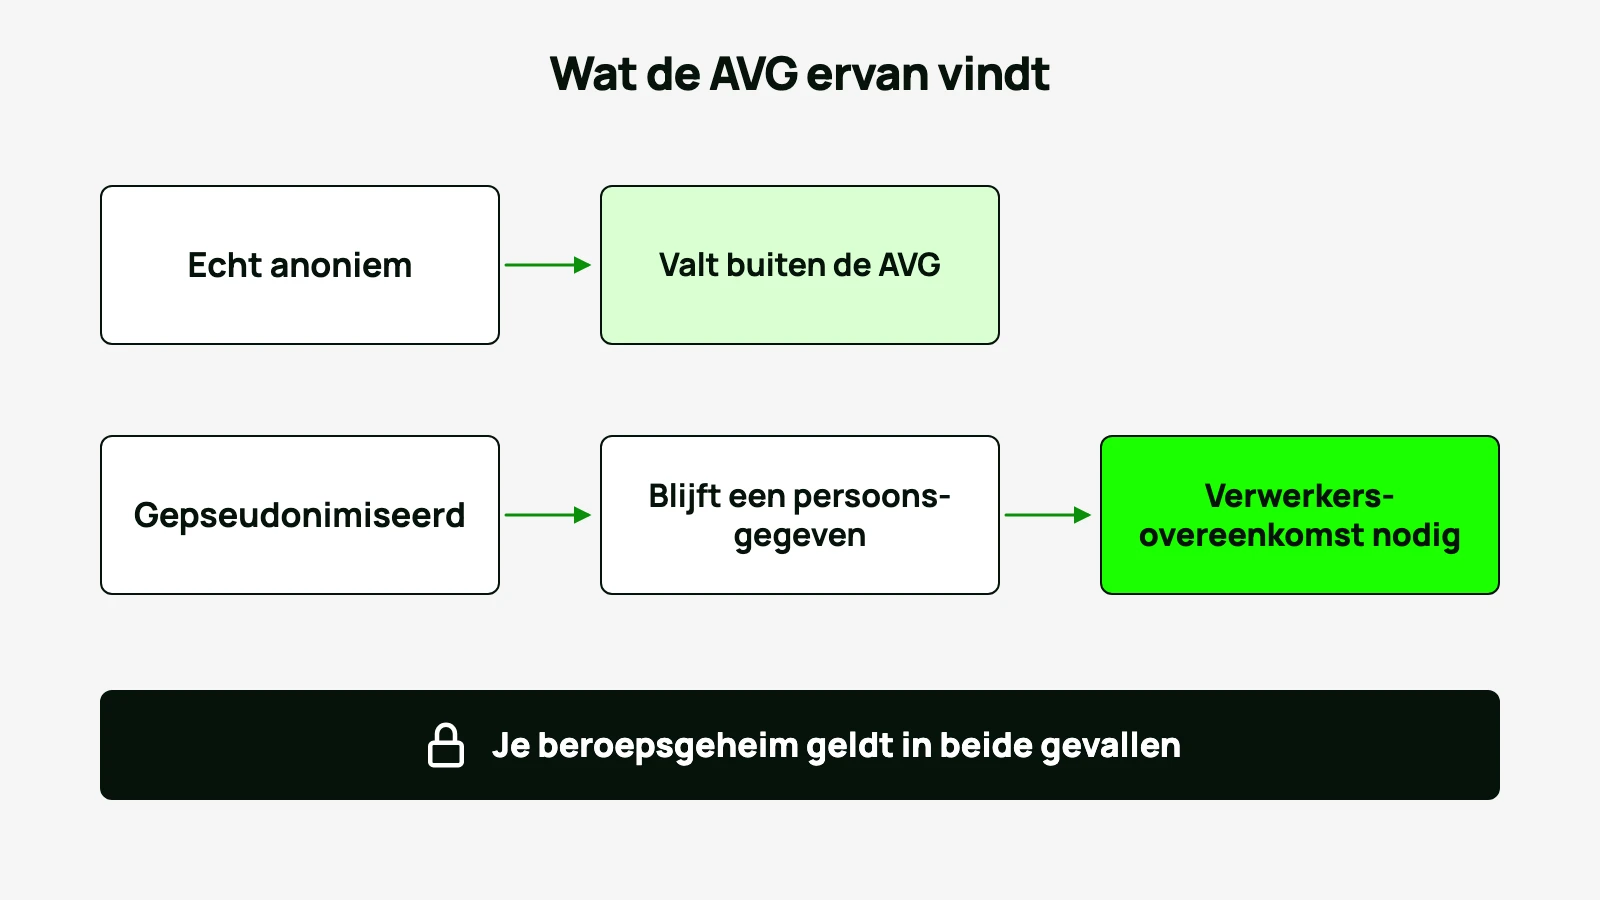
Dat heeft drie gevolgen voor je kantoor.
Een: geef je gepseudonimiseerde stukken aan een externe AI-dienst, dan gelden de AVG-regels gewoon. Bij uitbesteding van persoonsgegevens hoort een verwerkersovereenkomst. Dat zijn schriftelijke afspraken met de aanbieder over wat hij met de gegevens mag doen en hoe hij ze beveiligt.
Twee: je beroepsgeheim staat los van de AVG. Ook als een stuk volgens de privacywet in orde is, rekent je cliënt erop dat zijn zaak vertrouwelijk blijft. Een fout raakt je daarom twee keer: juridisch, als degene die verantwoordelijk is voor de gegevens, en professioneel, tegenover je cliënt.
Drie: of iets “echt anoniem” is, bepaal je niet met een zwarte stift. Het gaat erom of iemand de persoon redelijkerwijs kan terugvinden, ook door feiten te combineren. In een dossier met data, bedragen, functies en gebeurtenissen lukt dat bijna altijd. Het eerlijke antwoord is dus: anonimiseren in de zin van buiten de wet haal je bij een compleet dossier zelden. Pseudonimiseren met goede afspraken is het realistische doel.
De AI Act, de Europese wet voor kunstmatige intelligentie, kent per toepassing een risiconiveau. Een dossier laten samenvatten voor intern gebruik is een andere toepassing dan een systeem dat over mensen beslist. Laat per toepassing vastleggen waar die valt.
Wat je kunt doen: laat een collega of externe privacyadviseur in één alinea vastleggen of je dossiers anoniem, gepseudonimiseerd of ongewijzigd aanbiedt, en met welke verwerkersovereenkomst.
Wat de orde er sinds november 2026 over zegt
De Nederlandse orde van advocaten heeft op 16 november 2026 haar aanbevelingen voor AI aangescherpt. Elk kantoor krijgt het advies om schriftelijk vast te leggen welke toepassingen zijn toegestaan en welke gegevens ermee verwerkt mogen worden. Bij vertrouwelijke cliëntinformatie moet je weten waar de gegevens staan, wie erbij kan en of een buitenlandse autoriteit ze kan opvragen. De orde raadt aan om die informatie zo veel mogelijk binnen de Europese Economische Ruimte te houden. Pseudonimiseren past daar goed bij: wat het taalmodel niet te zien krijgt, kan ook nergens terechtkomen. Lees het nieuwsbericht op Mr. Online.
Documenten anonimiseren: wat haal je weg?
Anonimiseren van documenten begint met weten wat iemand herkenbaar maakt. Dat zijn twee soorten gegevens.
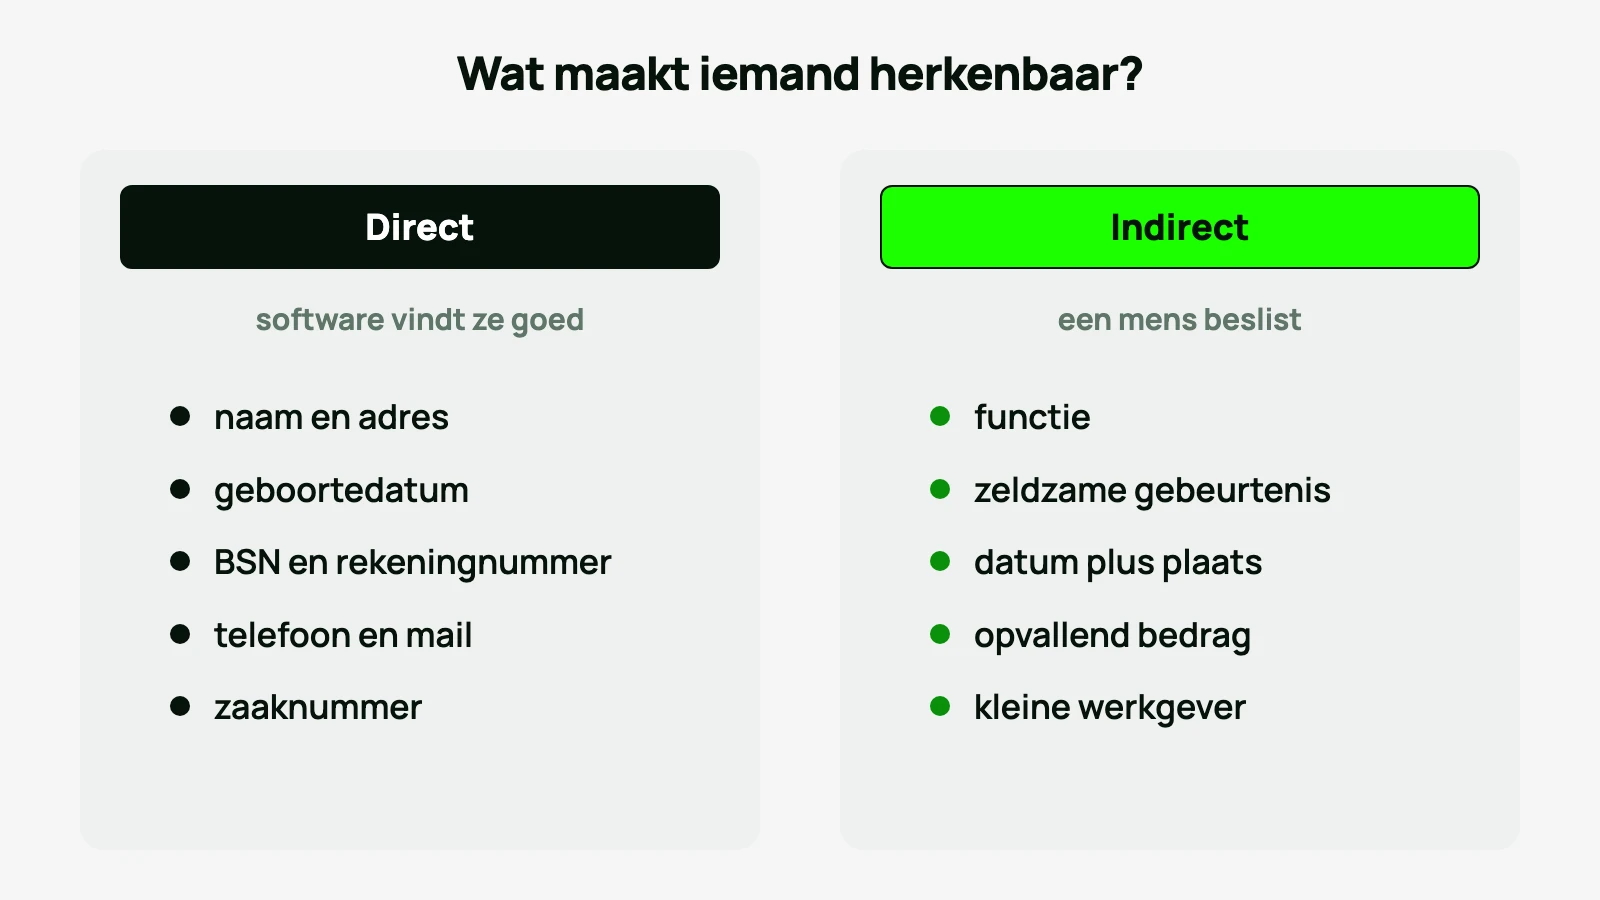
Directe gegevens wijzen rechtstreeks naar iemand: namen, adressen, geboortedata, burgerservicenummers, rekeningnummers, kentekens, telefoonnummers, mailadressen en zaaknummers. Software vindt die goed, want ze hebben een vast patroon.
Indirecte gegevens herkennen alleen mensen die de situatie kennen: een functie, een zeldzame gebeurtenis, een combinatie van datum en plaats, een opvallend bedrag, de naam van een kleine werkgever. Software vindt die slecht. Hier heeft de advocaat het laatste woord.
Pdf bestand anonimiseren
Bij een pdf bestand anonimiseren gaat het vaak mis op één punt. Een zwarte balk over de tekst leggen is niet hetzelfde als de tekst verwijderen. Veel programma's tekenen alleen een zwart vlak. Selecteer de tekst eronder, kopieer hem, en de naam staat er weer.
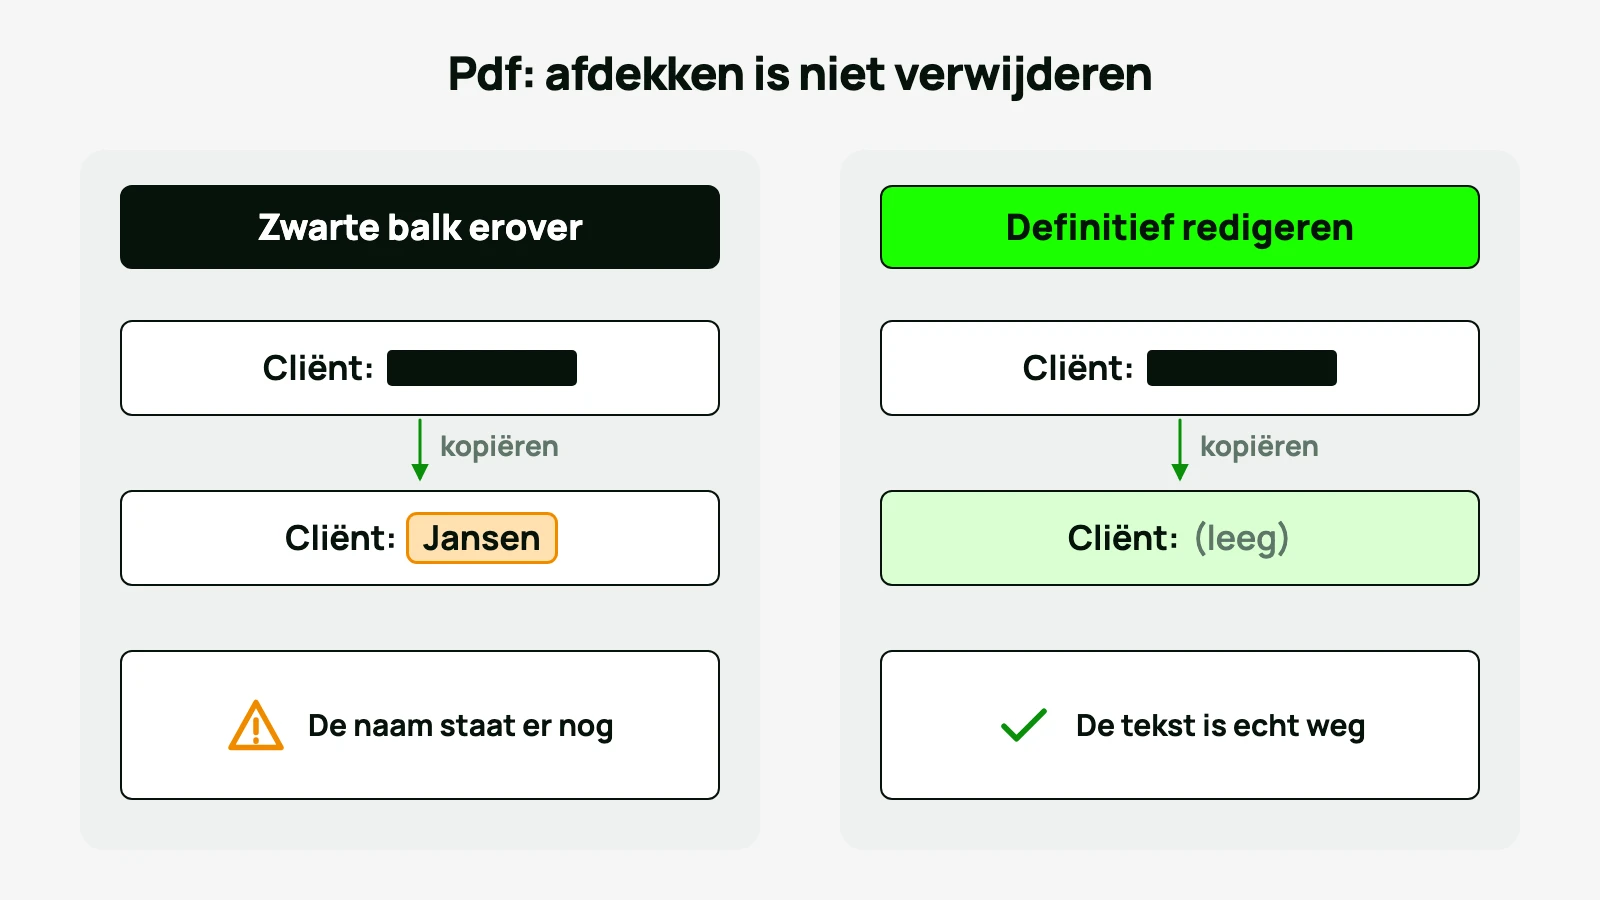
Gebruik daarom de functie voor definitief redigeren (in vaktaal heet dit redaction), die de tekst echt uit het bestand haalt. Is de pdf een scan, dan is de tekst eigenlijk een plaatje. Laat dan eerst tekstherkenning draaien: software die het plaatje omzet in tekst die je kunt doorzoeken. Controleer daarna altijd: zoek in het eindbestand op de naam van je cliënt en kijk in de bestandseigenschappen, want daar staan soms auteur en titel.
Opmerkingen anonimiseren in Word
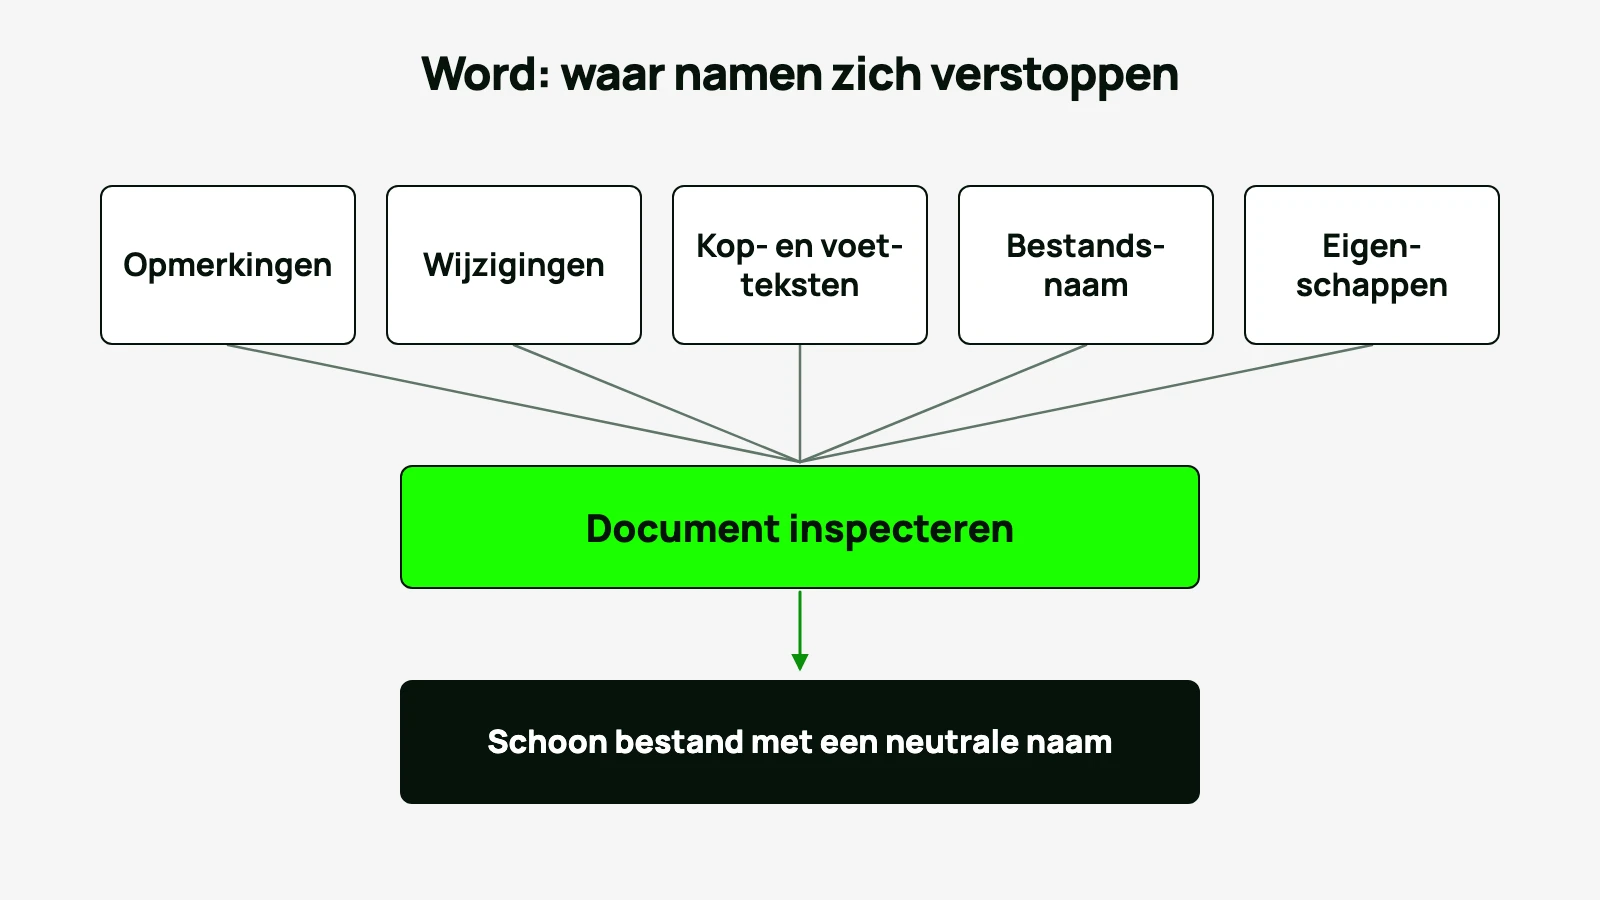
Bij opmerkingen anonimiseren in Word zit het risico in wat je niet ziet. Opmerkingen en bijgehouden wijzigingen bevatten de naam van de schrijver, en oude versies van zinnen blijven soms bewaard. Ook de kopteksten, de voetteksten en de bestandsnaam zelf (“Pleitnota Jansen.docx”) verraden meer dan je denkt.
Word heeft hiervoor een functie: Document inspecteren, te vinden onder Bestand, Info, Controleren op problemen. Die verwijdert opmerkingen, wijzigingen, verborgen tekst en persoonlijke eigenschappen. Doe dit op een kopie, want na opslaan is het verwijderen definitief, en geef het bestand daarna een neutrale naam of code.
Wat je kunt vragen: laat een medewerker bij elk eindbestand zien dat zoeken op de cliëntnaam niets oplevert, ook niet in opmerkingen en bestandseigenschappen.
Dossiers anonimiseren met AI: zo ziet het proces eruit
Handmatig dossiers anonimiseren kost uren en leidt tot gemiste namen. AI kan het werk grotendeels doen, maar alleen als de volgorde klopt. Een taalmodel vragen om zelf te anonimiseren werkt niet: dan heeft het je dossier al gezien. Het herkennen van namen moet gebeuren voordat het taalmodel iets krijgt, op een systeem dat jij beheert.
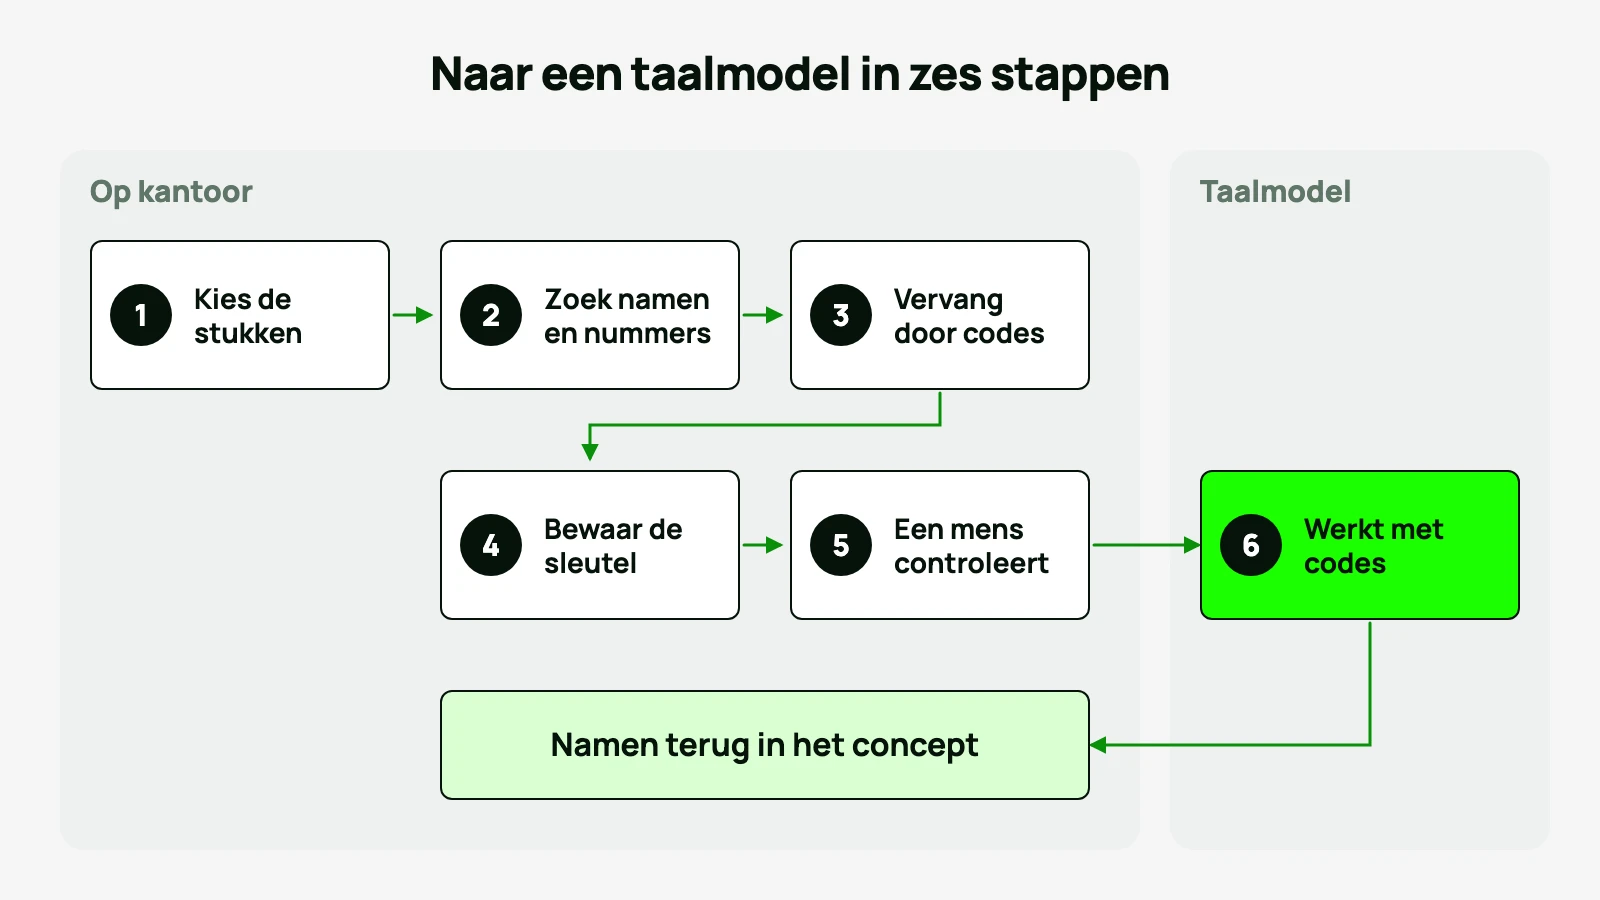
Zo loopt het in zes stappen:
- Kies welke dossiers en stukken in aanmerking komen. Zaken met veel unieke details laat je er bewust buiten.
- Laat software op je eigen systeem of op een server in de EU de herkenbare gegevens zoeken: namen, nummers, adressen.
- Vervang elk gevonden gegeven door een vaste code. Dezelfde persoon krijgt overal dezelfde code, zodat het verhaal leesbaar blijft.
- Bewaar de sleutel op kantoor, niet bij de aanbieder van het taalmodel.
- Laat een mens het resultaat controleren: bij gevoelige zaken volledig, anders met een steekproef.
- Laat het taalmodel pas dan werken en zet de echte namen daarna op kantoor terug in het concept.
Bouw het rustig op. Een logistiek bedrijf liet zijn systeem eerst meedraaien naast het team, zonder iets zelf te doen. Daarna maakte het conceptmails die een mens goedkeurde, en pas daarna mocht het zelf versturen voor vraagtypes met een laag risico. Dezelfde volgorde past hier: eerst meedraaien op dossiers die je al kent, dan de uitkomst naast je eigen handwerk leggen, dan pas gebruiken.
Wees ook eerlijk over wat AI niet kan. Het mist indirecte gegevens, zoals de enige tandarts van het dorp. Het maakt fouten en meldt die niet. De controle door een mens is daarom onderdeel van het proces, geen extra.
Wat je kunt vragen: aan een leverancier: waar draait de herkenning, wordt er iets bewaard of gelogd, wat gebeurt er als een naam gemist wordt, en kan ik de verwerkersovereenkomst vooraf lezen?
Voorbeeld: een arbeidsconflict met veertig stukken
Dit is een scenario, geen resultaat van een klant. Een advocatenkantoor met twaalf medewerkers bereidt een verweerschrift voor in een arbeidsconflict. Het dossier telt veertig stukken: contracten, mailwisselingen, gespreksverslagen en een paar scans. De advocaat wil een tijdlijn van de gebeurtenissen en een eerste overzicht van de sterke en zwakke punten.
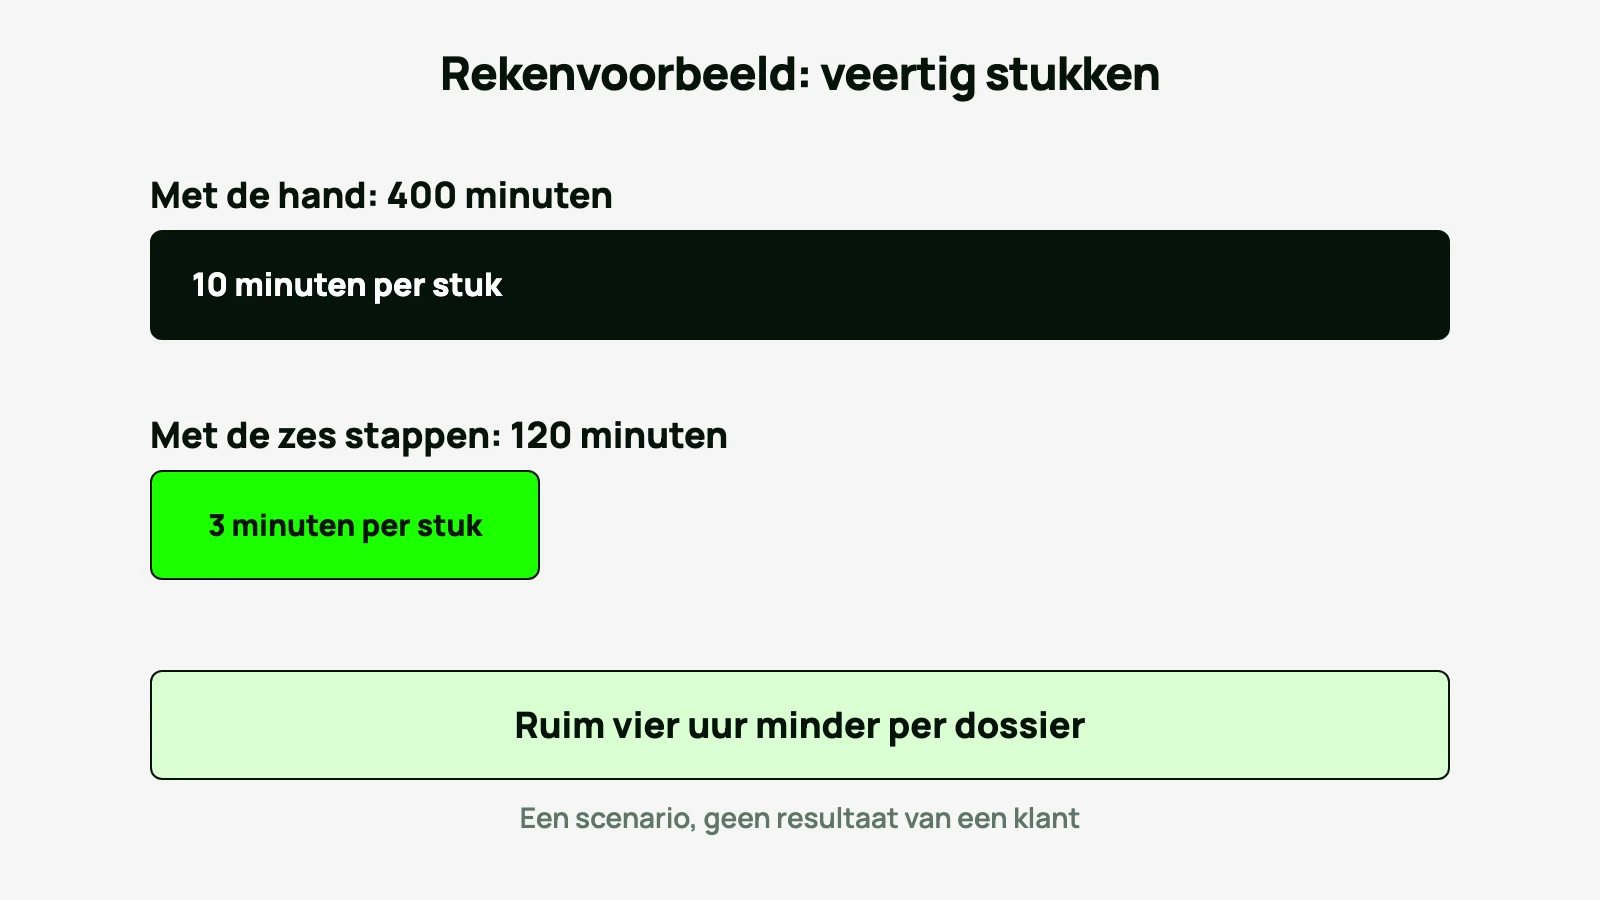
Zonder hulpmiddel: stel dat een medewerker per stuk tien minuten kwijt is om namen en nummers te vervangen en het resultaat te controleren. Dat is 400 minuten, ruim zes en een half uur. Veel kantoren slaan de stap dan over, of ze zetten het dossier ongewijzigd in een openbare AI-dienst. Beide zijn een risico.
Met de zes stappen: stel dat software de stukken voorbewerkt en de medewerker per stuk drie minuten controleert. Dat is 120 minuten, twee uur. De medewerker let vooral op indirecte gegevens, zoals de functie van de HR-manager in een bedrijf van dertig mensen, en past die aan. De advocaat krijgt de tijdlijn en de namen worden op kantoor teruggezet.
In dit voorbeeld scheelt het ruim vier uur per dossier. Bij tien van zulke dossiers per jaar is dat ruim veertig uur. Reken het na met je eigen getallen: hoeveel stukken telt een gemiddeld dossier en hoeveel minuten zijn je medewerkers er nu aan kwijt?
Wat blijft: de beoordeling van de zaak ligt bij de advocaat, en het eerste dossier kost meer tijd omdat je het proces test.
Wat je kunt doen: neem één afgesloten dossier, laat het proces erop draaien en leg het resultaat naast het handwerk. Dan weet je wat het bij jou oplevert.
Anonimiseren vs pseudonimiseren: samenvatting om te bewaren
Neem dit mee naar het gesprek met je leverancier of privacyadviseur.
Het verschil in vijf punten
- Terugrekenen naar de persoon: bij anonimiseren kan dat niet, bij pseudonimiseren wel met de sleutel.
- AVG: anonieme gegevens vallen erbuiten, gepseudonimiseerde gegevens blijven persoonsgegevens.
- Sleutel: bij anonimiseren bestaat er geen, bij pseudonimiseren bewaar je die op kantoor.
- Bruikbaarheid: bij pseudonimiseren zet je namen terug in een concept, bij anonimiseren niet.
- Haalbaarheid bij een dossier: anonimiseren zelden volledig, pseudonimiseren wel, met controle.
Checklist voor elk dossier
- ☐ Is bepaald welke stukken mogen?
- ☐ Zijn namen, nummers en adressen vervangen door codes?
- ☐ Zijn indirecte gegevens (functie, plaats, bedrag, datum) beoordeeld door een mens?
- ☐ Is bij pdf bestanden de tekst echt verwijderd en niet afgedekt?
- ☐ Zijn bij Word de opmerkingen, wijzigingen en bestandseigenschappen verwijderd?
- ☐ Staat de sleutel op kantoor?
- ☐ Ligt er een verwerkersovereenkomst met de aanbieder van het taalmodel?
- ☐ Is vastgelegd wie wat heeft gecontroleerd en wanneer?
Wanneer anonimiseren niet loont
Heb je maar enkele dossiers per jaar, dan is handwerk goedkoper dan een proces opzetten. Zijn de zaken zo bijzonder dat de feiten zelf de cliënt verraden, zoals bij een bekende partij of in een kleine gemeenschap, dan helpt geen enkele bewerking en hoort het dossier niet in een extern taalmodel.
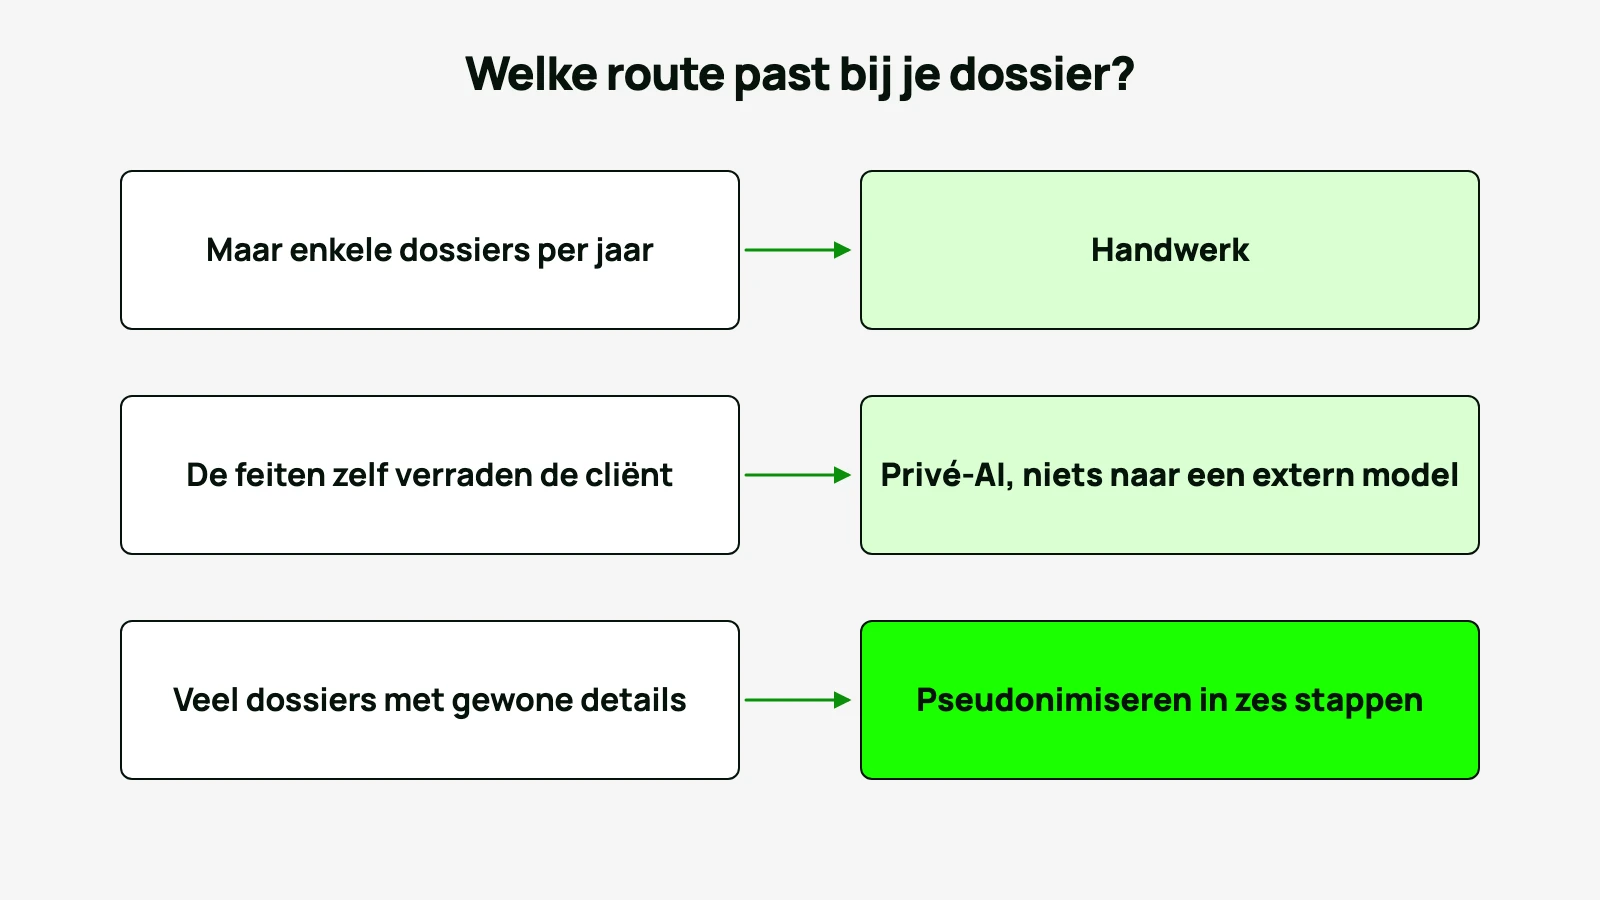
Dan is een andere route verstandiger: een privé-AI waarbij de gegevens nooit bij een extern model komen. Een bedrijf in de medische sector koos hiervoor, met de eis dat patiëntgegevens nooit bij het model komen en dat elke rol alleen ziet wat bij die rol hoort. Dat kan op een server bij een Europese hoster of op een eigen machine op kantoor, met dezelfde software. Dat bedrijf begon met een pilot van een paar weken en een meetrapport, en besloot pas daarna over het vervolg.
Je volgende stap
Wil je zien hoe dit voor een kantoor werkt, lees dan hoe we dossiers anonimiseren met AI aanpakken. Een eerste AI-agent staat bij Green Creatives in 4 weken live. Liever eerst praten? Plan een gesprek via de offerteaanvraag.